Remote Labor Index Update: Fable 5 Leads AI Automation at Just 16.1% of Real Freelance Work
Kurzfassung
最新一版 Remote Labor Index 基準測試顯示,Claude Fable 5 在 240 個真實接案專案裡拿下 16.1% 的自動化率,是目前最高分。這代表的是驚人進步,還是離取代人類還很遠?我們把費米估算攤開來看。
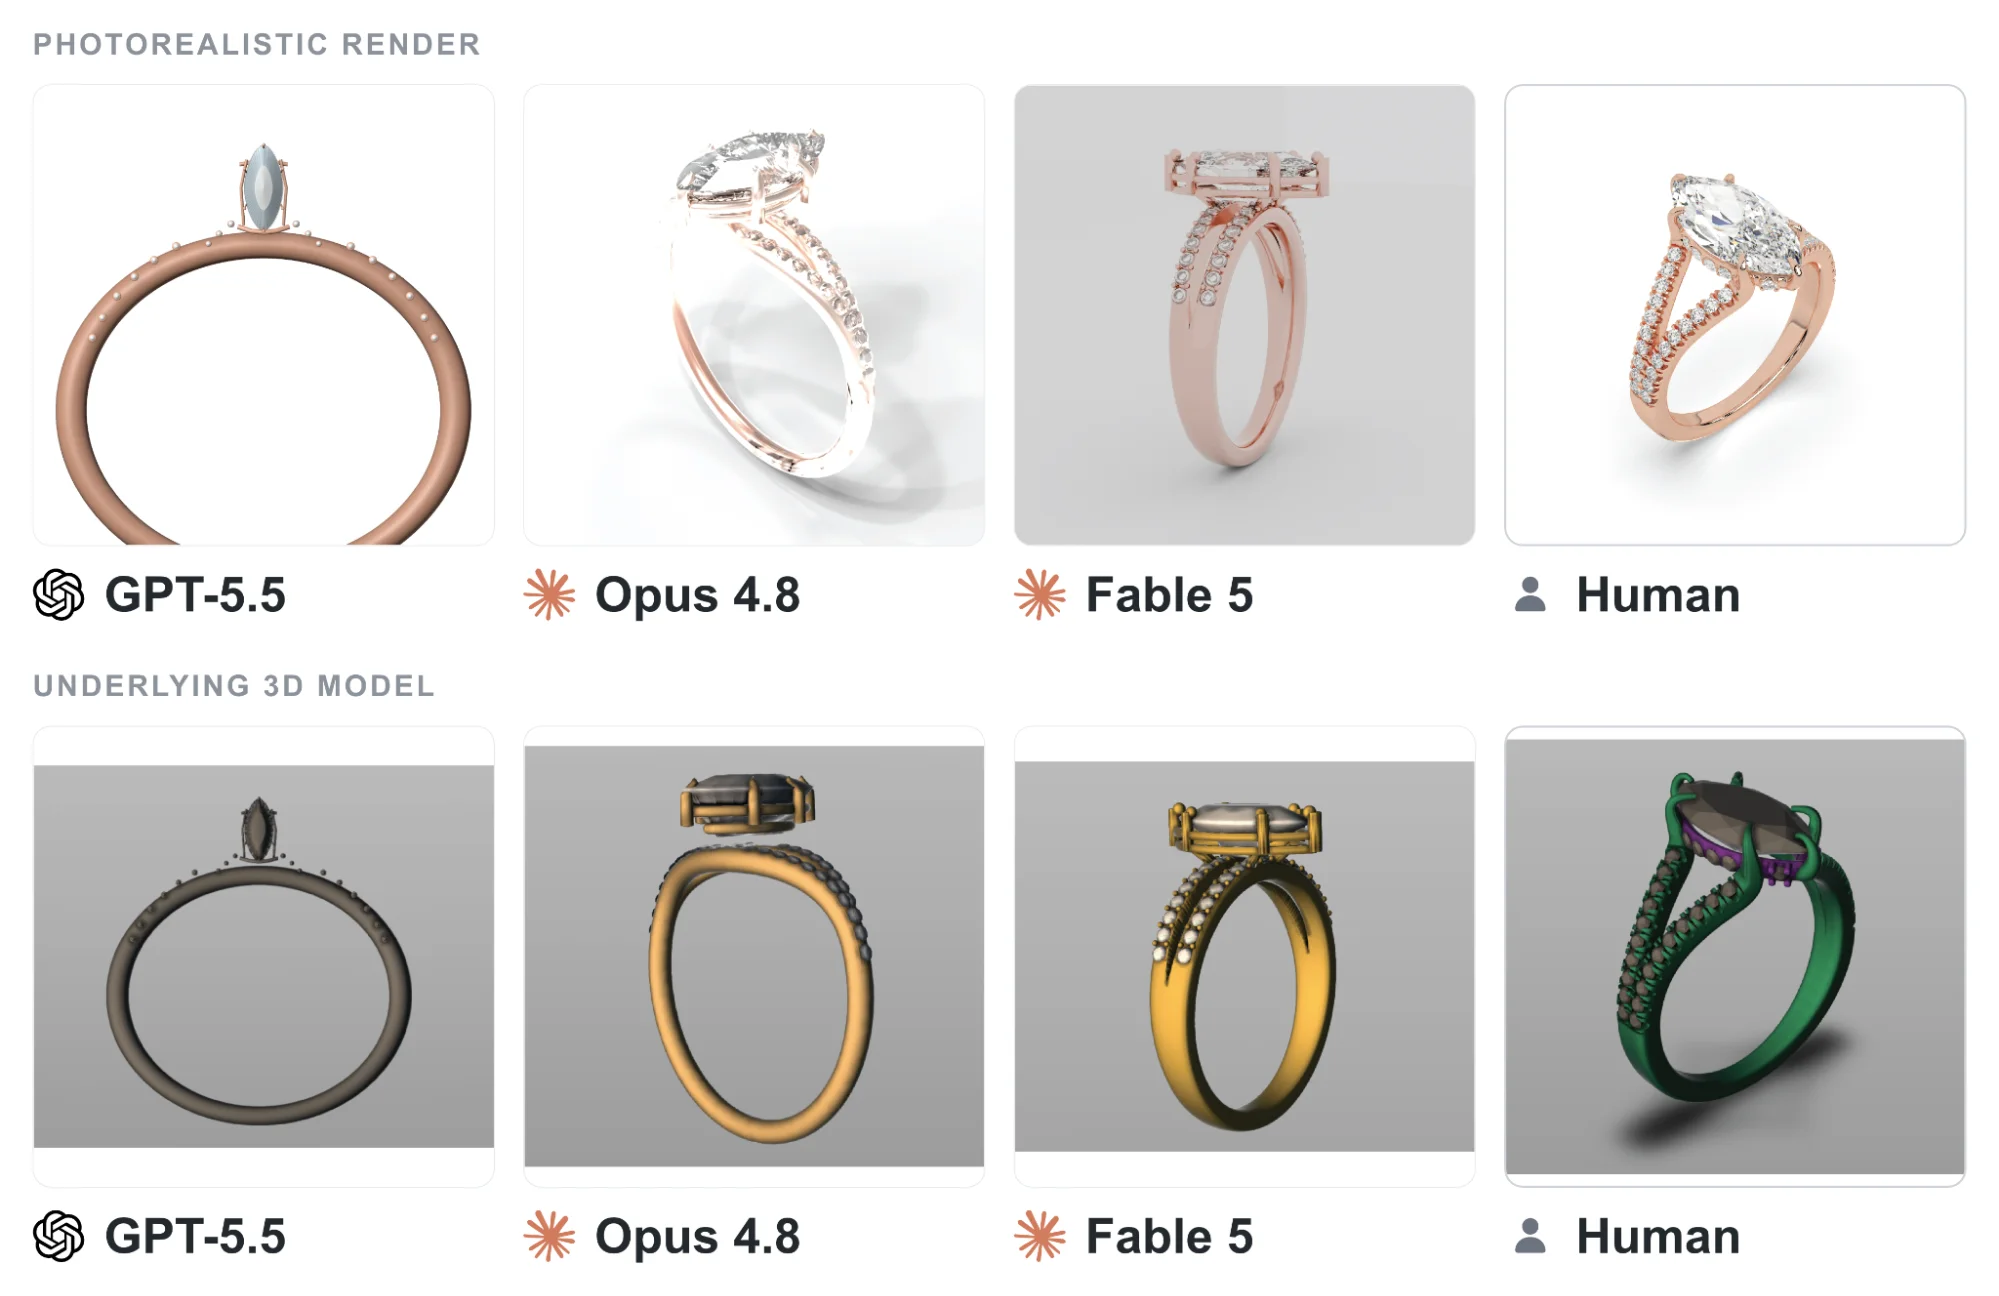
Meine These: Bei den aktuellen Rechenkosten lohnt sich Fable 5 als Freelancer-Ersatz noch nicht, selbst bei einer Automatisierungsrate von 16,1 Prozent. Teilt man das 150-Dollar-Budget pro Aufgabe durch die Erfolgsquote, landet man bei rund 930 Dollar pro tatsächlich abgenommener Lieferung, mehr als das Vierfache des Medianpreises von 200 Dollar, den ein menschlicher Freelancer für denselben Auftrag verlangt. Wer in der Praxis andere Zahlen sieht, etwa weil die Inferenzkosten fallen oder Wiederholungsversuche billiger sind als hier angenommen, soll mir gerne widersprechen.
Das Center for AI Safety und Scale AI haben am 1. Juli die neuesten Ergebnisse des Remote Labor Index veröffentlicht. Der Benchmark testet 240 echte Projekte aus Freelance-Marktplätzen, verteilt auf 23 Berufsfelder: 3D-Modellierung und CAD, Architektur, Grafikdesign, Video- und Audioschnitt, Datenanalyse, Webentwicklung und mehr. Jede Lieferung wird von menschlichen Gutachtern gegen das tatsächlich bezahlte Ergebnis bewertet, das ein echter Kunde erhalten hat. Anthropics Fable 5 führt mit einer Automatisierungsrate von 16,1 Prozent, Opus 4.8 liegt auf Platz zwei mit 8,3 Prozent, OpenAIs GPT-5.5 auf Platz drei mit 6,3 Prozent. Diese Runde hat nur 218 der 240 Projekte abgeschlossen, weil die US-Regierung mitten in der Auswertung den Zugang zu Fable 5 einschränkte, dieselbe Beschränkung, die das Modell im Juni schon einmal 19 Tage lang offline nahm. Diese Geschichte habe ich in einem separaten Artikel aufgearbeitet.
Der Index startete im Oktober 2025 mit GPT-5.2 an der Spitze bei 2,5 Prozent. Neun Monate später erreichte Opus 4.6 4,17 Prozent, Opus 4.8 kam auf 8,3 Prozent, und jetzt liegt Fable 5 bei 16,1 Prozent, jede Generation verdoppelt in etwa die vorherige. CAIS bezeichnet das in seiner Ankündigung als deutlichen Anstieg bei der Automatisierung digitaler Arbeit.
240 echte Freelance-Projekte, KI besteht nur 16,1 Prozent davon
Der Massstab von RLI unterscheidet sich von den meisten Benchmarks. Es geht nicht darum, ob ein Modell eine korrekte Antwort liefert, sondern ob ein zahlender Kunde die Lieferung annehmen würde. Jedes Modell bekommt bis zu 24 Stunden Bearbeitungszeit, Zugang zu einer A100-GPU und mehr als 30 professionelle Anwendungen, darunter Blender, FreeCAD, GIMP, Kdenlive und Audacity. Die Modelle laufen in Agent-Umgebungen wie Claude Code oder Codex CLI, und jede Lieferung durchläuft vor der Abgabe einen unabhängigen Kritiker-Agenten, einen sogenannten Worker-Critic-Loop. Das Budget liegt standardmässig bei 50 Dollar pro Aufgabe, bei Fable 5 wurde es auf 150 Dollar angehoben, weil die Inferenzkosten pro Aufgabe etwa sechsmal höher liegen als bei Opus 4.8.
Die Fehlermuster sind aufschlussreich. Von den gescheiterten Versuchen blieben 45,6 Prozent unter professionellem Niveau, 35,7 Prozent waren unvollständig oder fehlerhaft formatiert, der Rest verteilt sich auf technische Fehler und Inkonsistenzen innerhalb der Projektdateien. Modelle schneiden am besten bei generativer Arbeit ab, die von Grund auf entsteht, vor allem bei Audio und Bild, und am schlechtesten bei Projekten, die eine vorgegebene Spezifikation treffen oder bestehende Dateien schrittweise bearbeiten müssen.
Was die Zahlen wirklich zeigen
Die 16,1 Prozent selbst stehen nicht zur Debatte. Es sind die eigenen Daten von Scale AI und CAIS, die Methodik ist öffentlich in dem arXiv-Paper einsehbar, und jeder kann den Test wiederholen. Was mehr Skepsis verdient, ist die Schlussfolgerung, KI werde bald weisse-Kragen-Freelance-Arbeit ersetzen.
Zuerst die Kosten. Fable 5 verbrennt 150 Dollar pro versuchter Aufgabe bei einer Erfolgsquote von 16,1 Prozent, das ergibt rechnerisch etwa 930 Dollar Rechenkosten pro Lieferung, die tatsächlich die Messlatte reisst. Ein menschlicher Freelancer verlangt für denselben Auftrag im Median 200 Dollar. Diese Lücke bleibt bestehen, noch bevor man die Arbeitskosten für die Prüfung der KI-Ergebnisse einrechnet, denn wie die Forscher selbst anmerken, ist die Beurteilung, ob eine RLI-Lieferung professionellem Standard entspricht, selbst eine anspruchsvolle agentische Aufgabe und nicht etwas, das sich mit einer schnellen automatischen Prüfung abtun lässt.
Das führt zu einem zweiten Problem: wie sehr man automatisierter Bewertung überhaupt trauen kann. Wird derselbe Testsatz statt von einem menschlichen Gremium von einem LLM-Richter bewertet, fällt der Score von GPT-5.5 um etwa das 2,9-Fache zu hoch aus, bei Opus 4.8 um etwa das 2,3-Fache. Die Rangfolge bleibt erhalten, die absoluten Zahlen nicht. Jede Schlagzeile, die behauptet, ein Modell habe einen bestimmten Benchmark-Prozentsatz erreicht, verdient einen kräftigen Abschlag, sobald die Bewertung von einem anderen Modell statt von einem menschlichen Gremium stammt.
Zuletzt die Wachstumskurve. Der Sprung von 2,5 auf 16,1 Prozent sieht exponentiell aus, ist aber nicht das Ergebnis einer einzigen, stetig besser werdenden Architektur, sondern vier verschiedener Modellgenerationen, aufgeschichtet auf einer Agent-Toolchain, die selbst immer leistungsfähiger wird. Das Budget stieg von 50 auf 150 Dollar, der Werkzeugzugriff von einer Handvoll Anwendungen auf über 30. Ein Teil dieser Kurve gehört dem technischen Rahmenwerk, nicht der wachsenden Klugheit des Modells.
Worauf als Nächstes zu achten ist
Erstens, ob sich das Tempo beim nächsten RLI-Update hält und sich die Rate weiterhin alle paar Monate etwa verdoppelt. Wenn ja, könnte die Automatisierungsrate bis Jahresende auf rund 30 Prozent klettern, eine konkrete Zahl, die sich jetzt festhalten und später überprüfen lässt, statt einer vagen Prognose in die eine oder andere Richtung.
Zweitens, ob andere Benchmarks, die auf LLM-Richter setzen, bei derselben Überhöhung erwischt werden wie RLI. Sollte sich das bestätigen, braucht die Art, wie die Branche Benchmark-Werte zitiert, eine breite Neukalibrierung.
Drittens, ob sich die Kosten pro Aufgabe bei Fable 5 dem Niveau von Opus 4.8 annähern, sobald Inferenz günstiger wird. Das ist die Zahl, die entscheidet, wann automatisierte Freelance-Arbeit von einer Forschungskuriosität zu einem tragfähigen Geschäft wird.
Viertens, ob US-Zugangsbeschränkungen die RLI-Auswertung erneut unterbrechen. Es ist bereits das zweite Mal, dass eine politische Massnahme einen Testlauf verkürzt hat, und der Zeitpunkt der nächsten Einschränkung ist selbst ein Signal, das sich zu beobachten lohnt.
Wenn dieser Artikel hilfreich war, abonniere den Newsletter für wöchentliche KI-PM-Einblicke.
Weiterführende Artikel:
Verwandte Artikel
Google bringt TPUs ins All: Ein 15-Minuten-Test ist noch kein Dauerbetrieb
Google und Planet starten einen Suncatcher-Prototyp für Gemma-Tests mit vier TPUs. Im Orbit lassen sich Wärme- und Strahlungsannahmen prüfen; Kühlpausen, Dauerleistung und kommerzielle Kosten bleiben offen.
Google stellt Gemini 4 Argon vor: Code-Modernisierung braucht den richtigen Vergleich
Gemini 4 Argon erhöht das Ausgabelimit auf 1M Tokens und startet bei vertrauenswürdigen Cyberverteidigern. Das libgav1-Beispiel zeigt eine schnellere Rust-Portierung; der Faktor 2,7 bezieht sich jedoch nicht auf das optimierte C++-Original.