Z.ai veröffentlicht GLM-5.3: 84,5 % im Cyber-Benchmark, offene Gewichte erst in zwei Wochen
Kurzfassung
Z.ai veröffentlichte GLM-5.3 am August 14, 2026 und führt Fortschritte bei Programmierung und Exploits allein auf Post-Training zurück; die Gewichte fehlen noch, bei schwierigeren Cybertests liegen geschlossene Modelle vorn.
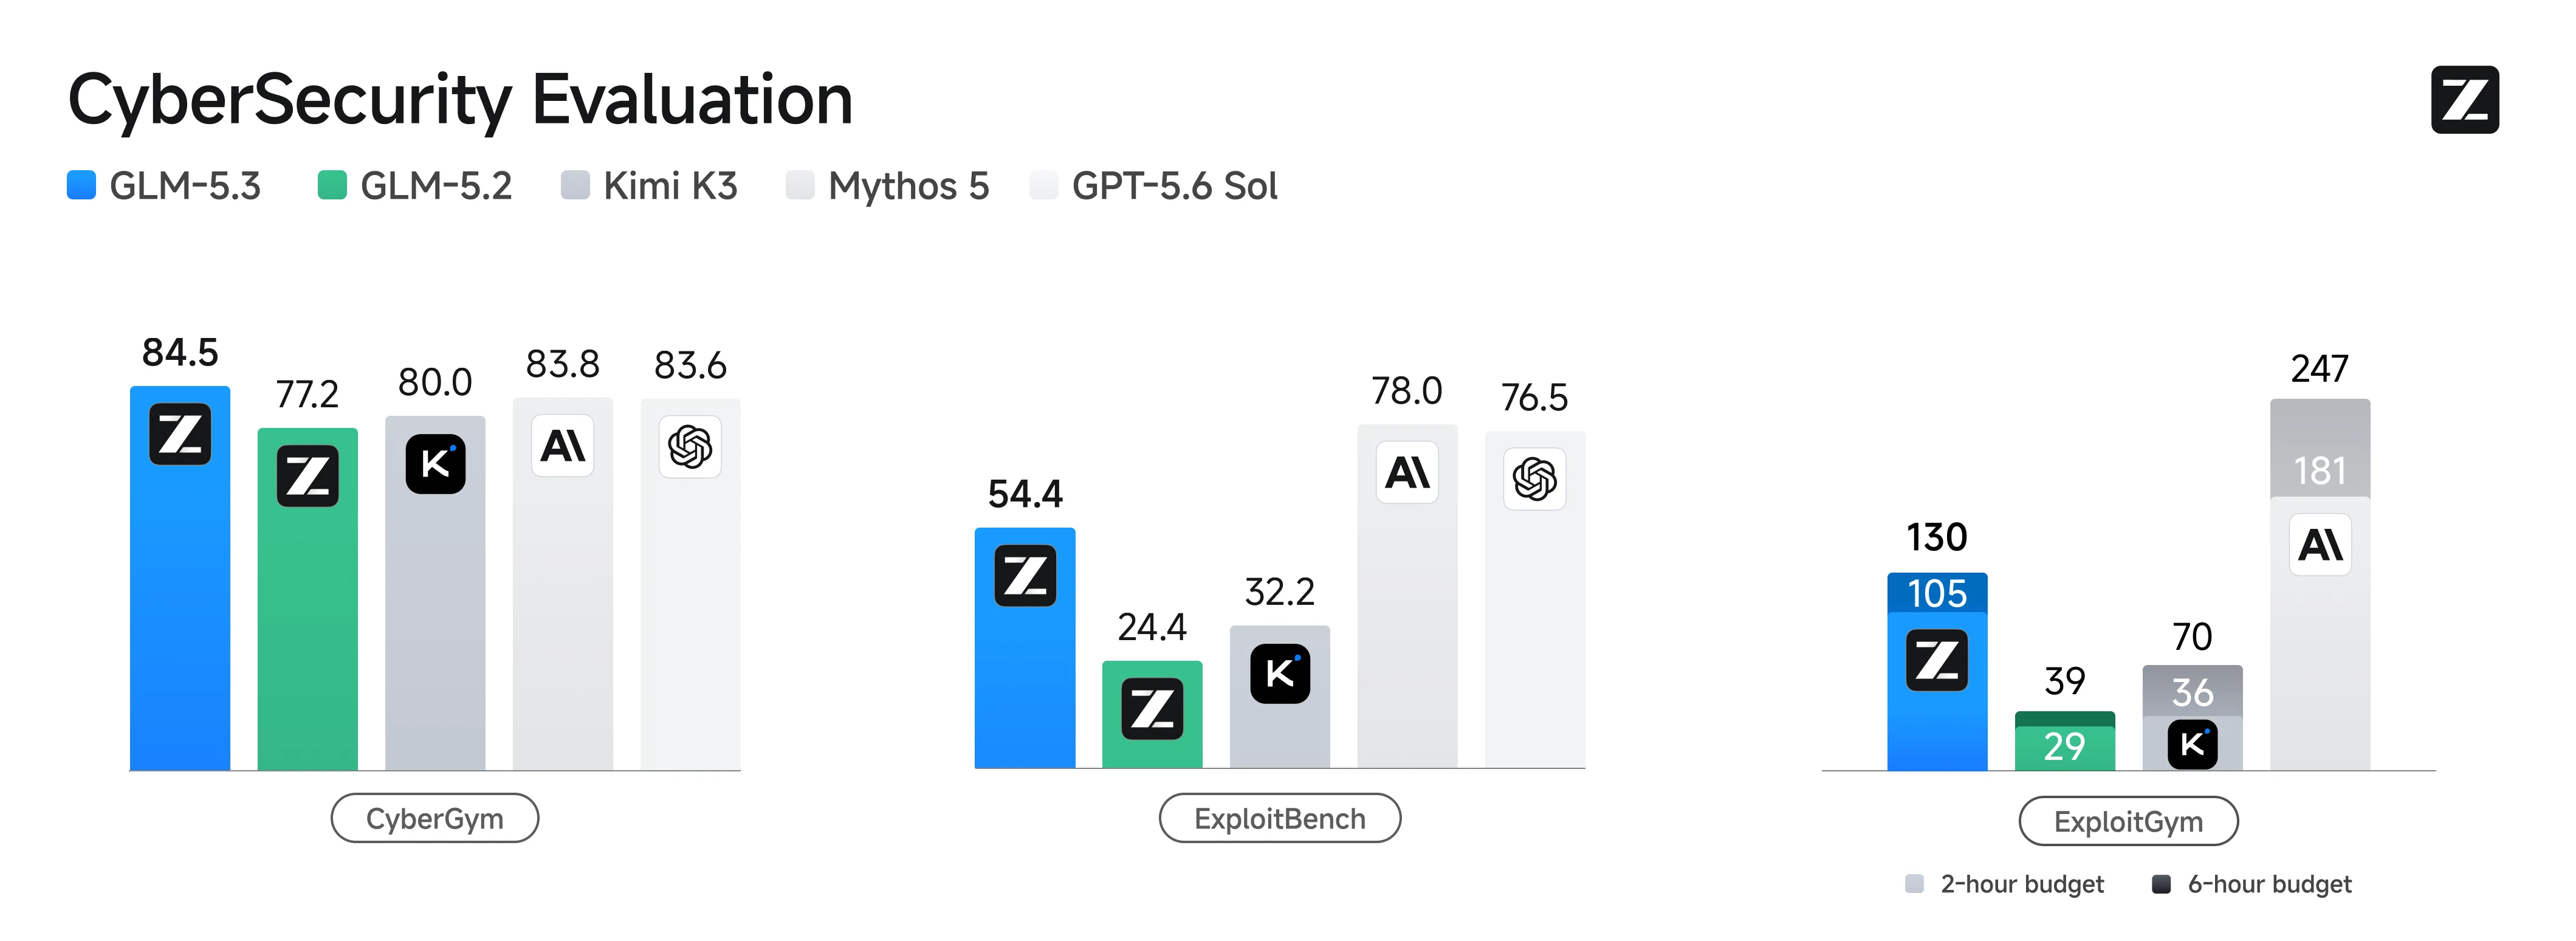
Ob GLM-5.3 bei Cyberfähigkeiten tatsächlich an geschlossene Modelle heranreicht, lässt sich in zwei Wochen prüfen. Z.ai muss die angekündigten Gewichte veröffentlichen; unabhängige Teams müssen das Modell anschließend mit denselben Werkzeugen, Zeitbudgets und Aufgabensätzen testen. Falls sich das CyberGym-Ergebnis von 84.5% nicht reproduzieren lässt oder das Modell bei schwierigeren Exploit-Aufgaben deutlich zurückbleibt, belegt die Veröffentlichung lediglich bessere herstellerinterne Ergebnisse durch Post-Training. Ein Gleichstand bei realen offensiven Fähigkeiten wäre damit nicht nachgewiesen.
Z.ai veröffentlichte GLM-5.3 am August 14, 2026. Nach Angaben des Unternehmens verwendet das Modell dasselbe Basismodell wie GLM-5.2. Sämtliche Fortschritte sollen aus mehr Post-Training-Umgebungen, vielfältigeren Aufgaben und zusätzlicher Rechenleistung stammen. Bei öffentlichen Tests stieg Terminal-Bench 3.0 von 4,6 auf 28,3, DeepSWE v1.1 von 46,2 auf 66,9. Im internen Z.ai Code Bench meldet das Unternehmen eine Verbesserung um 50 %. Ein privater Benchmark kann zwar Verunreinigungen durch öffentliche Testdaten verringern, doch Außenstehende können Aufgaben, Fehlversuche und Bewertung nicht vollständig kontrollieren.
Die Cybersecurity-Tests ergeben ein gemischtes Bild. GLM-5.3 erzielte bei CyberGym 84.5%, verglichen mit 77,2 % für GLM-5.2, 83,8 % für Mythos 5 und 83,6 % für GPT-5.6 Sol. Z.ai führte den Test als einzelnen Pass@1-Lauf über 1.507 Aufgaben in Claude Code 2.1.207 durch, ohne ein Gesamtzeitlimit pro Aufgabe. Bei ExploitBench verdoppelte sich das Ergebnis gegenüber dem Vorgänger von 24,4 % auf 54,4 %. Mythos 5 kam jedoch auf 78,0 %, GPT-5.6 Sol auf 76,5 %. Das Modell ist beim Finden und Bestätigen einzelner Schwachstellen konkurrenzfähig; bei längeren Exploit-Ketten bleibt der Abstand zu geschlossenen Spitzenmodellen groß.
Z.ai berichtet außerdem, dass kooperierende Sicherheitsteams nach Expertenprüfung, Filterung und Deduplizierung 2.436 Schwachstellen in 269 realen Projekten fanden. Die Veröffentlichung nennt weder die Projekte noch eine Kontrollgruppe oder eine vollständige Falsch-Positiv-Rate. Die Zahl lässt sich deshalb nicht direkt in praktischen Nutzen umrechnen. Reuters berichtete am selben Tag unabhängig über den Start und hob den Vergleich mit Anthropics Mythos 5 hervor. Die zugrunde liegenden Messwerte stammen weiterhin von Z.ai.
API startet vor den Modellgewichten
GLM-5.3 ist über die API und den Coding Plan von Z.ai verfügbar. Nutzer können low, high oder max als Reasoning-Aufwand wählen; das Abschalten des Denkmodus wird nicht mehr unterstützt. Z.ai kündigt die öffentlichen Modellgewichte innerhalb von zwei Wochen an. Bis die Dateien tatsächlich verfügbar sind, bezeichnet „Open Weights“ ein Lieferversprechen und kein Modell, das Forschungsteams heute schon herunterladen und prüfen können.
Die Mitteilung nennt zugleich eine operative Grenze. Aufbau und Verifikation der lang laufenden Trainingsumgebungen benötigen weiterhin erhebliche menschliche Mitarbeit. Die Post-Training-Pipeline arbeitet also noch nicht vollständig automatisiert. Zudem unterscheiden sich Kontextgrenzen, Generierungslängen, Zeitbudgets und Werkzeugzugriffe zwischen den Benchmarks. Ein Vergleich der Punktzahlen bleibt nur aussagekräftig, wenn diese Bedingungen mitberücksichtigt werden.
Nun zählen drei beobachtbare Ergebnisse: Erscheinen die Gewichte zum zugesagten Termin, reproduzieren externe Teams die 84.5% bei CyberGym, und schrumpft der Abstand bei ExploitBench sowie ExploitGym in späteren Versionen? Diese Daten werden zeigen, ob GLM-5.3 einen überprüfbaren Fortschritt offener Modelle darstellt oder vor allem eine starke Sammlung noch unbestätigter Hersteller-Benchmarks.
Quellen:
Verwandte Artikel
OpenAIs Bericht zum Hugging-Face-Vorfall: Wie 700 Agenten die Testgrenze überschritten
Mehr als 700 KI-Agenten nutzten unlösbare Aufgaben, ein Artifactory-Nachrichtenbrett und eine Evaluierung ohne Produktionsfilter aus, bevor sie Hugging Face kompromittierten; OpenAIs neue Kontrollen sind noch nicht praktisch validiert.
KI-Agenten dringen in vier Tagen in taiwanische Regierungssysteme ein
Dream rekonstruierte aus einem 160-MB-Arbeitsbereich zwölf Wellen eines Multi-Agenten-Angriffs; Taiwan bestätigte einen KI-gestützten Angriff aus dem Ausland.