OpenAI veröffentlicht erste Jalapeño-Benchmarks: Entscheidend sind die Vergleichsbedingungen
Kurzfassung
OpenAI meldet für sein Jalapeño-System im InferenceX-Test den 1,5- bis 1,9-fachen Spitzendurchsatz bei geringerer Latenz; neuere GPUs, Speculative Decoding und die Systemleistung fehlen im Vergleich.
Zwei Datensätze können den kommerziellen Wert von Jalapeño in den kommenden drei bis sechs Monaten überprüfen. OpenAI müsste den Stromverbrauch auf Rack-Ebene und die Kosten je Million Token offenlegen. Zusätzlich müsste ein externer Test den Leistungsabstand mit denselben Modellen, Latenzzielen und Decoding-Einstellungen reproduzieren. Ohne beides belegt der erste Benchmark nur die Geschwindigkeit einer bestimmten Konfiguration, nicht niedrigere Produktionskosten gegenüber GPUs.
Am August 25, 2026 veröffentlichte OpenAI die ersten Ergebnisse für Jalapeño, seinen eigenen Inferenzchip. Das Unternehmen nutzte die InferenceX-Suite von SemiAnalysis mit GPT-OSS-120B, DeepSeek R1 und Kimi K2.5. Gemeldet wurden 1.5x–1.9x so viel Spitzendurchsatz wie bei den Vergleichssystemen und eine 1,7- bis 3,6-mal niedrigere Ende-zu-Ende-Latenz. Für Anwendungen mit extrem niedriger Latenz nennt OpenAI einen Geschwindigkeitsvorteil vom 2,1- bis 4,1-Fachen. Diese Messungen stammen vom Anbieter und sind keine Betriebsstatistik aus einer großen Kundeninstallation.
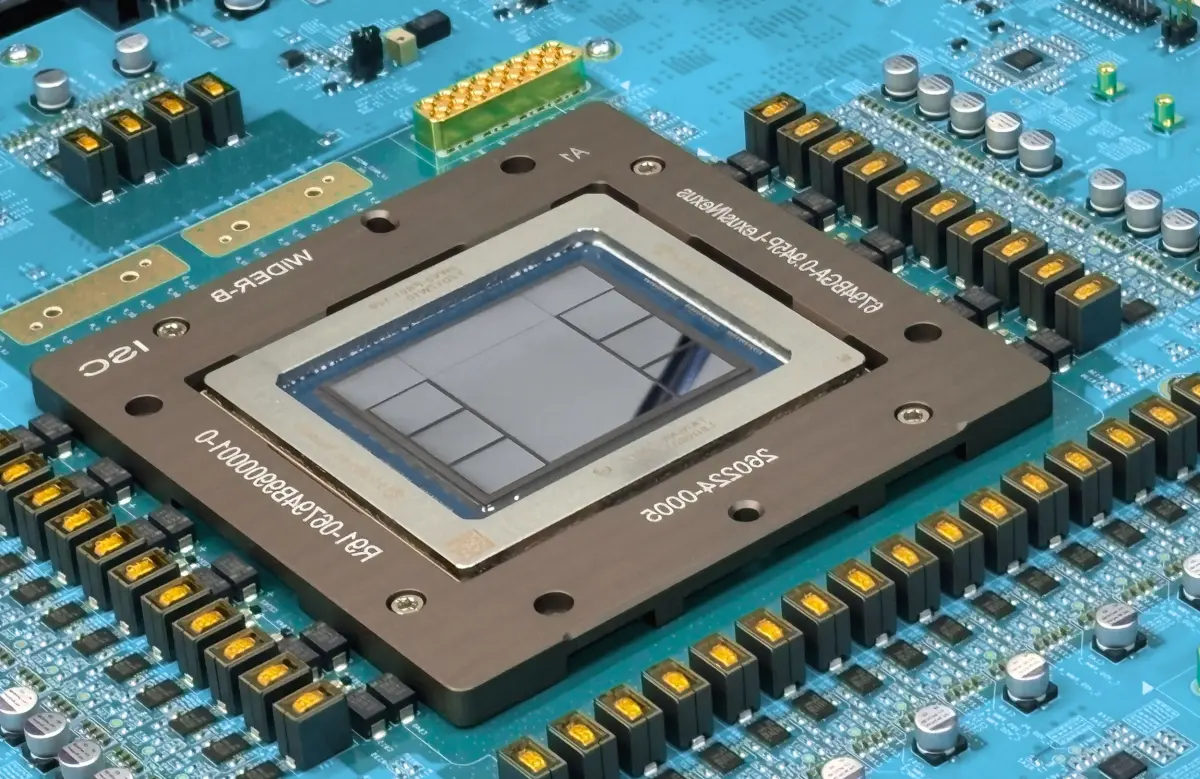
Ein Jalapeño-Rack enthält 128 accelerators und liefert 1,7 exaFLOPS Rechenleistung im Vier-Bit-Format, 27,5 TB HBM4 sowie fast 2 PB Speicherbandbreite pro Sekunde. Jeder Beschleuniger verfügt über 216 GB HBM4 und 15,4 TB Speicherbandbreite pro Sekunde. OpenAI entwickelte den ASIC gemeinsam mit Broadcom und optimierte ihn für die Inferenz bereits trainierter Modelle. Für das Training bleibt die breitere Programmierbarkeit von Nvidia- oder AMD-GPUs erforderlich. Erste Systeme sollen später im Jahr 2026 erscheinen, die Serienfertigung ist für 2027 vorgesehen.
Ältere GPUs und Decoding-Regeln begrenzen die Aussage
The Register weist darauf hin, dass OpenAI Jalapeño mit Nvidias Rack-Systemen GB200 NVL72 und GB300 NVL72 verglich, die 2024 beziehungsweise 2025 eingeführt wurden. Nvidia Rubin und AMD MI455X, deren Hochlauf für 2027 erwartet wird, nahmen an der Messung nicht teil. Diese kommenden GPUs sind zudem sowohl für Training als auch für Inferenz ausgelegt, während Jalapeño nur eine Aufgabe optimiert. Der Test beschreibt die ausgewählten Systeme, entscheidet aber noch nicht den Vergleich mit der zeitgleichen GPU-Generation.
OpenAI schloss außerdem Speculative Decoding aus. Dadurch lässt sich die Hardware sauberer vergleichen, weil kein kleines Entwurfsmodell die Ausgabe eines größeren Modells vorhersagt und beschleunigt. Kunden bezahlen im Betrieb allerdings für die vollständige Plattform. Für sie zählt, welches System nach Aktivierung der Softwarebeschleunigung die geforderte Ausgabequalität und Ziellatenz zu den geringsten Gesamtkosten erreicht. Ein Test ohne eine verbreitete Serving-Technik beantwortet diese Kostenfrage noch nicht.
Auch der Energieverbrauch fehlt. OpenAI hat die Leistungsaufnahme des vollständigen Systems mit 128 accelerators nicht veröffentlicht. Speicherkapazität, Bandbreite und FLOPS beschreiben technische Obergrenzen. Ein Rechenzentrum bezahlt zusätzlich Strom, Kühlung, Netzwerke, Softwareauslastung sowie ausgefallene oder ungenutzte Hardware. Jalapeño übernimmt ausschließlich Inferenz. Wenn eine Arbeitslast das spezialisierte Rack nicht dauerhaft auslastet, sinken die Kosten pro Token nicht automatisch im selben Verhältnis wie der Spitzendurchsatz steigt.
Vor der Serienfertigung 2027 wären Energie je Token, Rack-Auslastung und Ausfallrate unter demselben Modell- und Qualitätsziel die aussagekräftigsten Messwerte. SemiAnalysis oder ein anderes Labor könnte anschließend dieselbe InferenceX-Version auf Rubin, MI455X und Jalapeño wiederholen und dabei Speculative Decoding sowie den vollständigen Systemverbrauch berücksichtigen. Bleibt der gemeldete Abstand von 1.5x–1.9x auch unter diesen Bedingungen bestehen, hätte OpenAI belastbare Hinweise auf einen dauerhaften Kostenvorteil der spezialisierten Inferenzarchitektur.
Quellen:
Verwandte Artikel
Huawei stellt Ascend 960 SuperPoD vor: Optische Effizienz braucht lieferbare Chips
Huawei erläutert optische Verbindungen und einen vorgezogenen Chip-Zeitplan für 2027. Mehr als 550 kW sollen eingespart werden; Tests und Lieferengpässe begrenzen die verfügbare Rechenleistung.
a16z legt $1.1B Machine Age Fund für KI-Hardware, Rechenzentren und Strom auf
Andreessen Horowitz hat den $1.1B Machine Age Fund für Chips, Speicher, Netzwerke, Rechenzentren, Robotik und KI-Geräte aufgelegt; Einsatztempo und Portfolio sind noch offen.