Z.ai 發布 GLM-5.3:資安基準升至 84.5%,開放權重仍要等兩週
重點摘要
Z.ai 在 August 14, 2026 發布 GLM-5.3,宣稱只靠後訓練改善程式開發與漏洞利用能力;公開基準進步明顯,但權重尚未釋出,較難的攻擊測試仍落後封閉模型。
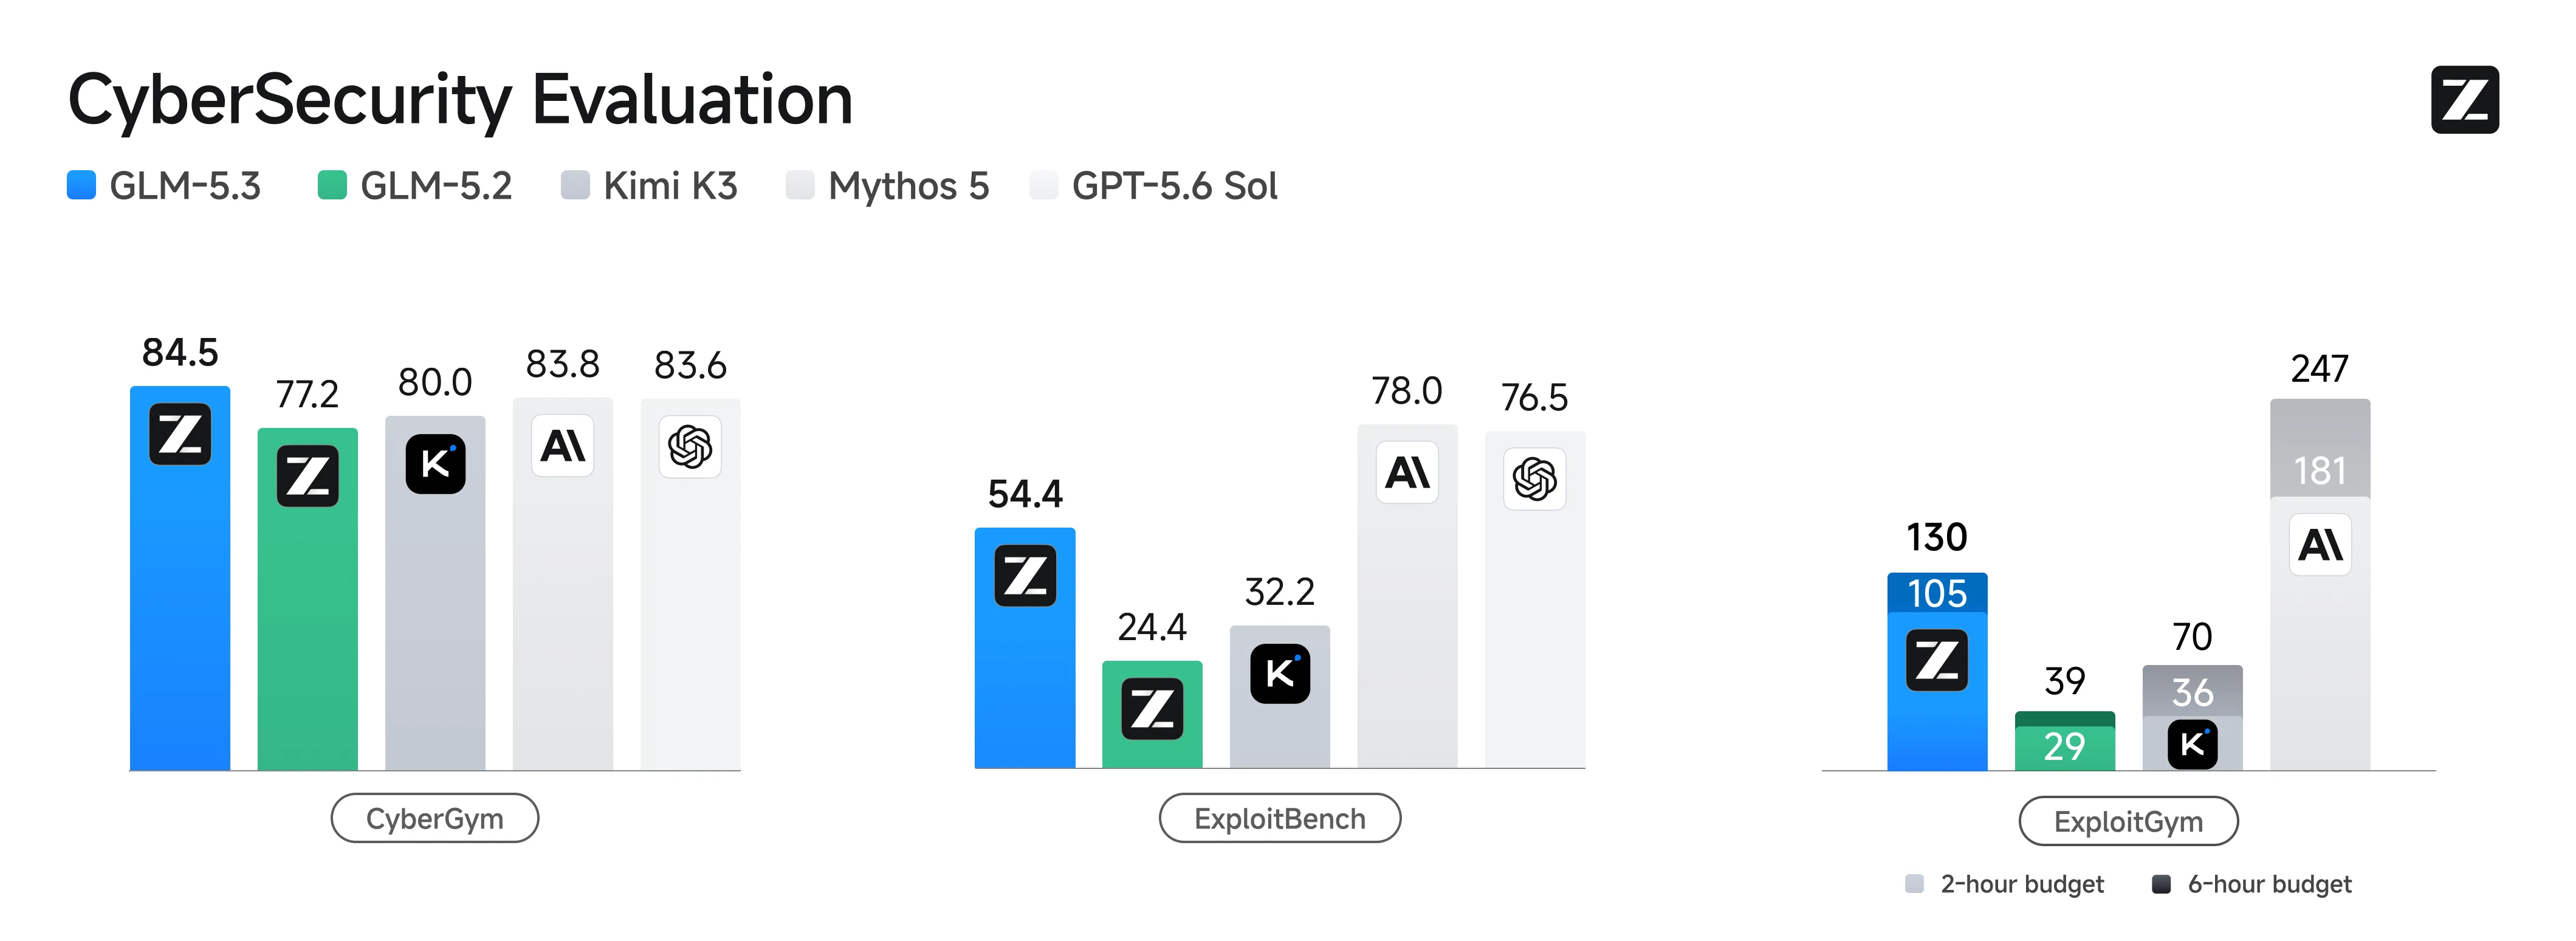
GLM-5.3 的資安能力是否真的接近封閉模型,兩週後就有可檢驗的條件:Z.ai 必須如期公開權重,第三方也要在相同工具、時間限制與任務集合下重跑測試。若 CyberGym 的 84.5% 無法重現,或模型在較難的漏洞利用任務持續大幅落後,這次發布只能證明後訓練改善了供應商測試結果,還不能證明實際攻防能力已追上領先模型。
Z.ai 在 August 14, 2026 發布 GLM-5.3。公司表示它沿用 GLM-5.2 的基礎模型,所有進步都來自增加後訓練環境、任務種類與算力。公開數據顯示,Terminal-Bench 3.0 從 4.6 升至 28.3,DeepSWE v1.1 從 46.2 升至 66.9;公司自建的 Z.ai Code Bench 則稱整體提升 50%。後者是私有基準,可降低公開題庫污染,外界也無法獨立檢查題目、失敗案例與評分方式。
資安測試呈現兩種結果。GLM-5.3 在 CyberGym 取得 84.5%,高於 GLM-5.2 的 77.2%、Mythos 5 的 83.8% 與 GPT-5.6 Sol 的 83.6%。這項測試使用 1,507 個任務、單次 Pass@1、每題不設總逾時,並在 Claude Code 2.1.207 執行。模型在 ExploitBench 從 24.4% 升至 54.4%,進步超過一倍;Mythos 5 與 GPT-5.6 Sol 仍分別達到 78.0% 與 76.5%。模型找出漏洞的能力接近前段班,串起完整利用鏈時仍有明顯差距。
Z.ai 另稱,合作資安團隊經人工審查、篩選與去重後,從 269 個真實專案找到 2,436 個漏洞。公司沒有公開專案清單、對照組或完整誤報率,因此這個數字不能直接換算成部署效益。Reuters 同日報導也把焦點放在模型接近 Mythos 5 的資安測試,相關比較仍源自 Z.ai 提供的結果。
API 先上線,權重延後
GLM-5.3 已開放 API 與 Coding Plan,用戶可選 low、high、max 三種推理強度,不能關閉思考模式。Z.ai 表示模型權重將在兩週內公開;在那之前,「open-weights」仍是交付承諾,不是研究者已能下載驗證的狀態。公司也承認環境生成與驗證仍需相當程度的人工介入,擴大後訓練尚未成為全自動流程。
接下來可量測的結果很具體:權重是否在承諾期限內出現、CyberGym 的 84.5% 能否由外部團隊重現,以及 ExploitBench 與 ExploitGym 的落差是否在更新後縮小。這三項資料會決定 GLM-5.3 是一個可審核的開放模型進展,或主要是一組尚待外部驗證的供應商基準。
來源: