OpenAI 公布 Jalapeño 首批測試:推論晶片快多少仍取決於比較條件
重點摘要
OpenAI 的 Jalapeño 系統在 InferenceX 測試中聲稱達到 1.5 至 1.9 倍尖峰吞吐量與較低延遲;測試仍未納入新一代 GPU、推測解碼及系統功耗。
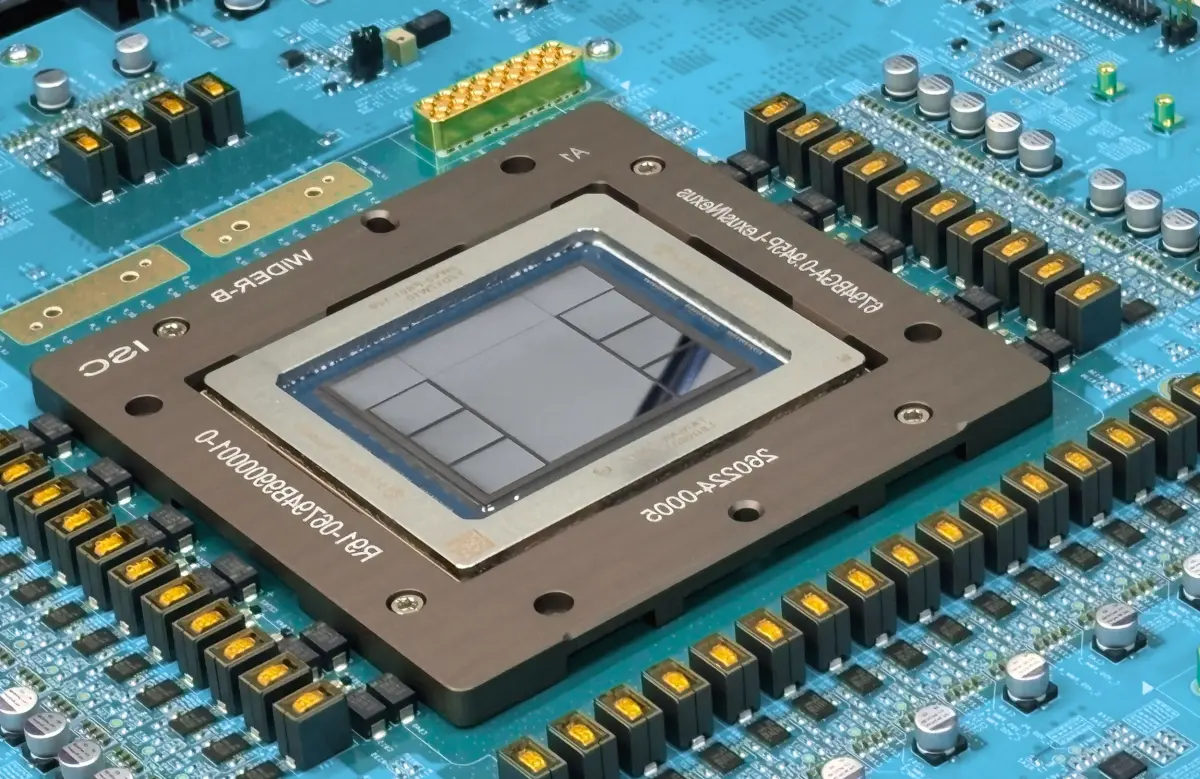
Jalapeño 的商業價值可以在未來三到六個月用兩組資料檢驗:OpenAI 是否公布整櫃功耗與每百萬 token 成本,以及外部測試能否在相同模型、延遲與解碼設定下重現效能差距。缺少其中一組,首批基準只能證明特定測試配置的速度,還不能證明實際服務成本已低於 GPU。
OpenAI 在 August 25, 2026 公布自研推論晶片 Jalapeño 的首批結果。公司以 SemiAnalysis 的 InferenceX 套件測試 GPT-OSS-120B、DeepSeek R1 與 Kimi K2.5,聲稱系統在尖峰吞吐量提供競品的 1.5x–1.9x,在端到端延遲方面快 1.7 至 3.6 倍;超低延遲情境的速度差距則為 2.1 至 4.1 倍。這些數字來自 OpenAI 的測試,不是晶片已在客戶環境大規模部署後的統計。
一套 Jalapeño 機櫃配置 128 accelerators,合計提供 1.7 exaFLOPS 的 4-bit 運算、27.5 TB HBM4,以及接近每秒 2 PB 的記憶體頻寬。每顆晶片配備 216 GB HBM4,記憶體頻寬為每秒 15.4 TB。OpenAI 與 Broadcom 共同開發這款 ASIC,用途集中在已訓練模型的推論;訓練工作仍需要較具可程式化彈性的 Nvidia 或 AMD GPU。公司預計 2026 年稍晚開始供貨,2027 年才進入量產。
舊 GPU 與解碼設定限制了結論
The Register 指出,OpenAI 選用的比較系統是 Nvidia GB200 NVL72 與 GB300 NVL72,兩者分別在 2024 與 2025 年推出。預計 2027 年擴大量產的 Nvidia Rubin 與 AMD MI455X 並未進入這輪比較;這兩款 GPU 同時服務訓練與推論,產品定位也不同。OpenAI 的測試還排除推測解碼。這有助於單獨比較硬體,卻無法回答完整服務平台開啟加速技術後,哪一方能以最低成本達到相同延遲與輸出品質。
OpenAI 尚未公布整套 128 accelerators 系統的功耗。記憶體容量、頻寬與 FLOPS 能描述硬體上限,資料中心實際支付的費用還包括電力、冷卻、網路、軟體利用率與晶片良率。Jalapeño 只處理推論,若工作負載不足以長時間維持高利用率,專用晶片的峰值優勢不一定會等比例轉成每 token 成本。
2027 年量產前最具辨識力的結果,是 OpenAI 公布相同模型與服務品質下的每 token 能耗、整櫃利用率及故障率,SemiAnalysis 或其他實驗室再以 Rubin、MI455X 與 Jalapeño 重跑相同版本的 InferenceX。若 1.5x–1.9x 的吞吐量差距在新一代硬體、推測解碼與完整功耗條件下仍存在,Jalapeño 才能證明專用推論架構帶來可持續的成本優勢。
來源: